Mi experiencia: un EDA sobre los festivales de Barcelona
Hay preguntas que parecen sencillas hasta que intentamos responderlas con datos. Por ejemplo: ¿cuándo se concentran los festivales de Barcelona? ¿Qué ámbitos culturales tienen más presencia? ¿Hay diferencias entre los festivales públicos y los privados? ¿Los festivales gratuitos atraen a más gente? ¿Están creciendo los macrofestivales? Son preguntas fáciles de formular. Lo complicado a veces empieza cuando queremos comprobarlas.
Porque ahí vienen nuevas preguntas: ¿Qué consideramos que es «un festival»? ¿Qué datos necesitamos? ¿Dónde podemos encontrarlos? ¿Qué hacemos cuando los datos no están preparados exactamente como los necesitamos? ¿Cómo decidimos qué variables comparar? ¿Y qué pasa cuando los resultados no confirman lo que esperábamos? En este artículo quiero acompañarte en ese recorrido a través de un caso concreto: un análisis de los festivales artísticos de Barcelona entre 2013 y 2022.
Los festivales son, en este caso, el objeto que utilicé para experimentar. Me gustan, me interesan y tenía curiosidad por saber qué podía encontrar en sus datos. Pero lo que me interesa contar aquí es algo más amplio: cómo se piensa y se desarrolla un análisis exploratorio de datos (EDA), incluso cuando no vienes de la programación ni de la ciencia de datos. Porque muchas veces la parte más interesante del análisis ocurre bastante antes de que aparezca el primer gráfico.
1. Todo empieza con una pregunta
Mi punto de partida fueron cuatro intuiciones sobre los festivales de Barcelona. En realidad, las preguntas que me interesaban no eran tan sofisticadas. Eran cosas bastante básicas: ¿cómo ha cambiado esto con el tiempo?, ¿de qué hay más?, ¿hay diferencias entre estos dos grupos de eventos?, ¿ese patrón que damos por supuesto aparece realmente en los datos? Me movía la curiosidad por entender cosas del sector, no por demostrar si mis hipótesis iniciales eran ciertas o no.
Porque una de las cosas que más me gustan del análisis de datos es precisamente la posibilidad de poner nuestras intuiciones a prueba. Algunas se confirmarán, otras necesitarán matices y otras pueden resultar directamente equivocadas. Si ya sabemos de antemano cuál es la respuesta, analizar los datos pierde buena parte de su sentido. Y aquí aparece el primer principio que me gustaría trasladar a cualquier persona que quiera empezar a hacer análisis:
Empieza por una pregunta que realmente te interese.
Puede ser sobre festivales, pero también sobre exposiciones, museos, bibliotecas, actividades educativas, públicos, patrimonio, programación cultural, participación, subvenciones o cualquier otro ámbito sobre el que tengas curiosidad. No necesitas empezar con una gran pregunta de investigación.
2. Antes de analizar, hay que buscar los datos
Una vez formulada la pregunta, el siguiente paso no es abrir una herramienta de análisis: es buscar qué datos existen. Esto parece obvio, pero creo que es una de las cosas que más fácilmente olvidamos cuando empezamos a trabajar con datos. Podemos tener una pregunta muy interesante y, sin embargo, no disponer de la información necesaria para responderla. O podemos descubrir que sí existe información, pero está repartida entre diferentes fuentes. O que los datos están publicados, pero no exactamente con las variables que necesitamos.
Cuando trabajo con una pregunta cultural, suelo empezar por las fuentes públicas: portales de datos abiertos municipales, autonómicos y estatales, estadísticas oficiales y las propias instituciones que generan o gestionan esos datos. A veces la fuente está exactamente donde esperarías; otras, toca buscar un poco más. En mi caso encontré datos abiertos del Ayuntamiento de Barcelona que permitían trabajar con información sobre festivales de la ciudad durante el período 2013–2022.
Y aquí aparece una cuestión que me parece especialmente interesante cuando trabajamos en cultura: los datos abiertos pueden convertirse en una infraestructura para investigar. Hay mucha información generada por administraciones públicas que puede reutilizarse para formular preguntas que quizá nunca estuvieron en el origen de esos datos. Por eso, cuando tengo una pregunta, intento incorporar una segunda:
¿Qué datos abiertos existen que puedan ayudarme a responderla?
Porque primero hay que saber si tenemos algo que analizar.
Una brújula para buscar datos culturales
A raíz de este artículo que estás leyendo, pensé que podría ser muy útil desarrollar un apartado en Cultumática donde reunir fuentes de datos municipales, autonómicas, estatales y otras que puedan servir para investigar fenómenos culturales. No solo datasets sobre festivales. También equipamientos, actividades, patrimonio, museos, públicos, estadísticas culturales y otros recursos que puedan resultar útiles. Y así ha nacido una versión inicial de directorio de datos abiertos relacionados con cultura que será un recurso vivo: una página que iré actualizando y ampliando a medida que encuentre nuevas fuentes.
Porque encontrar datos también forma parte del trabajo. Y quizá una de las cosas más útiles que podemos hacer desde los ámbitos culturales sea precisamente aprender a mirar qué información pública tenemos a nuestra disposición y qué preguntas nuevas podemos hacernos con ella.
3. Encontrar un dataset no significa tener un dataset listo
Aquí empieza una de las partes menos visibles del análisis. Encontré los datos. Bien. Ahora tocaba averiguar qué tenía realmente delante. ¿Qué representa cada fila? ¿Qué variables hay? ¿Qué años cubren? ¿Todos los registros siguen la misma lógica? ¿Hay valores que faltan? ¿Hay categorías que significan lo mismo pero aparecen escritas de distintas maneras? ¿La información está preparada para responder a las preguntas que me hice? La respuesta, como suele ocurrir, fue: más o menos. O incluso, más menos que más.
Tenía fechas, información sobre asistencia, ámbito cultural, titularidad y otras variables útiles. Pero tener una variable en el dataset no significaba necesariamente que estuviera lista para responder a la pregunta que yo quería hacerle. Y esto es importante. Los datasets no suelen llegar preparados específicamente para tu pregunta. Una administración puede haber creado una base de datos para gestionar una determinada actividad. Tú puedes llegar después con una pregunta completamente diferente y querer utilizar esos datos para responderla.
Por eso una de las primeras tareas de un EDA consiste en conocer el dataset antes de intentar sacarle conclusiones. Y aquí empieza algo que para mí terminó siendo una de las partes más interesantes (y laboriosas) del proyecto.
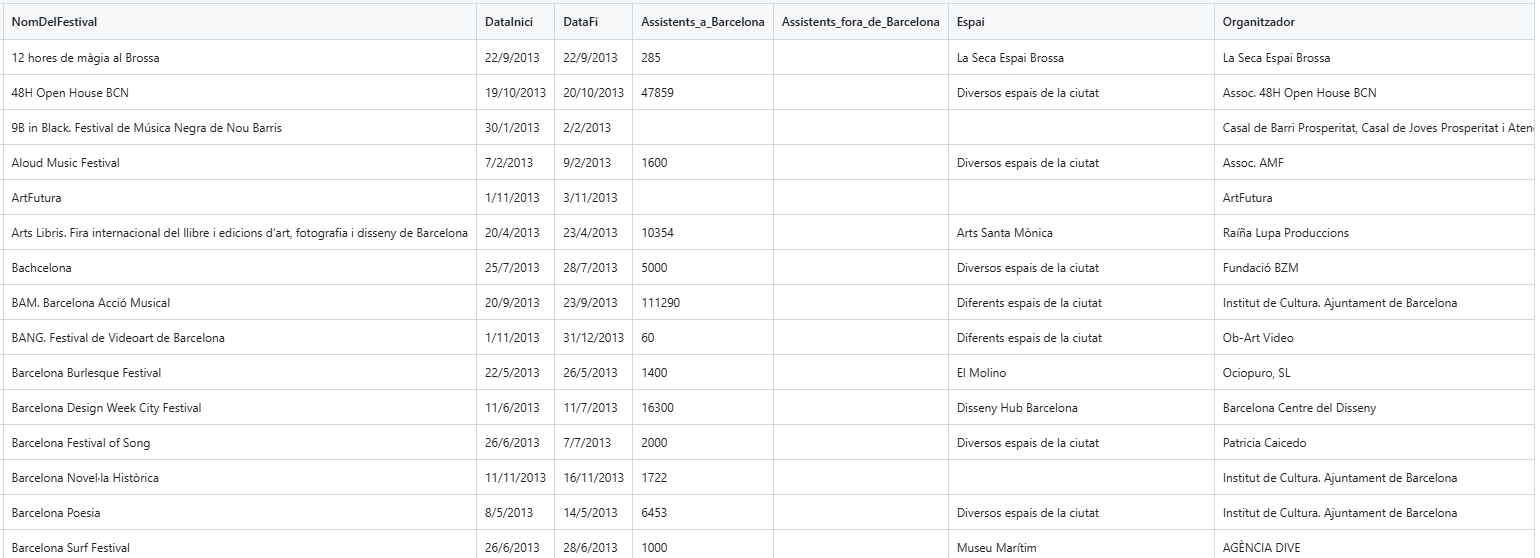
Una parte del dataset utilizado para el análisis exploratorio de los festivales de Barcelona.
4. Limpiar los datos es empezar a conocerlos de verdad
Hay una parte del análisis de datos que desde fuera puede parecer bastante ingrata: limpiar. A mí me ocurrió lo contrario. Cuanto más tiempo pasaba con los datos, más interesantes se volvían. Al principio los miraba desde cierta distancia. Después empecé a abrir columnas, comparar años, buscar valores extraños, agrupar categorías, comprobar registros, transformar variables y volver atrás cuando una decisión no terminaba de convencerme. Y poco a poco empezaba a conocerlos.
Durante la limpieza empiezas a tener una relación realmente íntima con tus datos: los desnudas, los manoseas un poco, los miras desde distintos ángulos, descubres qué esconden y también qué no tienen. Y, sobre todo, empiezas a hacerte preguntas. ¿Por qué este registro es diferente? ¿Por qué aquí aparece una categoría que no aparece en otros años? ¿Estos dos valores significan realmente lo mismo? ¿Este dato extraño es un error? ¿O precisamente estoy ante un caso excepcional que merece la pena conservar? Una diferencia que al principio parecía una molestia puede llevarte a descubrir una relación.
Una categoría mal formada puede hacerte revisar cómo estabas definiendo el fenómeno. Un valor extraño puede enseñarte algo sobre los límites del dataset. Por eso la limpieza puede consumir muchísimo tiempo. En un proyecto real, perfectamente puede ocupar considerablemente más tiempo que la fase final de análisis y visualización. Y, sin embargo, es una de las partes que menos se ven cuando enseñamos el resultado.
Limpiar no es simplemente borrar
Esta es una distinción importante. A veces limpiar significa eliminar un registro que no pertenece al universo que estamos estudiando. Pero otras veces significa:
- normalizar una categoría
- combinar campos
- transformar un valor
- corregir una inconsistencia
- hacer comparables distintos años
- documentar una decisión.
En este análisis, eso significó hacer cosas bastante poco vistosas: decidir qué registros pertenecían realmente al universo festivalero que quería estudiar, normalizar categorías que necesitaba comparar, combinar campos que por separado no me servían como indicador y crear variables que no existían tal cual en la fuente. Y algunas de esas decisiones terminaron cambiando las preguntas que podía hacerle a los datos. Por eso prefiero pensar en la limpieza como construcción de los cimientos.
Si están mal construidos, puedo hacer después un gráfico precioso, calcular una media con muchos decimales y construir una visualización muy sofisticada… Y todo puede estar respondiendo mal a la pregunta. La limpieza es poco glamurosa, pero sostiene todo lo demás.
5. Y aquí aparece una primera decisión: ¿qué analizo cuando analizo “festivales”?
Esta es una de las cosas que más me interesa del análisis porque parece una cuestión puramente descriptiva y en realidad no lo es. ¿Qué festival merece ser tenido en cuenta? Necesitamos un criterio bastante claro que podamos convertir en una regla aplicable de manera consistente. Para este análisis utilicé una definición operativa de festival y establecí además unos criterios para construir el universo a analizar: de todo el listado de festivales que ya aparecía como tal en el dataset, seleccioné los 50 festivales con mayor volumen de asistentes de cada año y exigí que aparecieran al menos en tres ediciones. El resultado fue un universo de 67 festivales. ¿Por qué tres ediciones?
Porque quería estudiar fenómenos con cierta continuidad y no tratar de la misma manera un evento puntual y uno que había tenido presencia sostenida durante la década. Eso también tenía un coste: al exigir continuidad dejaba fuera festivales puntuales o con menor presencia, aunque pudieran ser relevantes por otros motivos. Lo mismo pasa con el criterio de asistencia. Cada corte de selección me ayudaba a construir un universo más manejable y coherente con la pregunta, pero también hacía que dejara de ver parte del fenómeno. ¿Podría haber elegido otro criterio? Sí. Y eso es precisamente lo importante.
Es decir: no estoy descubriendo una categoría natural que estuviera escondida en los datos. Estoy construyendo un criterio operativo que me permite responder una pregunta concreta. Esta es una de las primeras ocasiones en las que aparecen las tres capas de decisiones que veremos que atraviesan todo el análisis:
🔧 Decisiones técnicas
¿Cómo preparo y transformo los datos?
🔎 Decisiones analíticas
¿Qué registros incluyo? ¿Qué comparo? ¿Qué calculo?
🧠 Decisiones epistemológicas
¿Qué estoy diciendo que representa la categoría que acabo de construir?
Definir el universo a estudiar pertenece especialmente a las dos últimas. Y esto es trasladable a prácticamente cualquier análisis cultural. Si estás estudiando exposiciones, tendrás que decidir qué consideras una exposición. Si analizas actividades educativas, qué cuenta como actividad. Si estudias proyectos culturales, qué entra y qué queda fuera. Los datos no suelen resolver esas preguntas por nosotros.
Cada vez que tomo una decisión sobre los datos, también estoy decidiendo qué voy a poder ver.
6. Construir las variables que necesito
Llegado este punto ya tenía una estructura bastante más manejable. Pero todavía faltaba algo importante: las variables que necesitaba para responder mis preguntas no siempre existían tal cual.
Y aquí aparece un concepto que puede sonar bastante técnico pero que en realidad describe algo muy sencillo: feature engineering, o ingeniería de características o construcción de variables derivadas. La idea es:
Construir una nueva variable a partir de la información disponible porque esa nueva variable nos permite responder mejor a la pregunta que nos hemos planteado.
Por ejemplo, yo tenía fechas. Pero una de mis preguntas era: ¿cuál es la temporada de festivales en Barcelona? Y esto se puede leer de más de una forma. Por ejemplo: ¿en qué meses se concentran los festivales? Necesitaba, por tanto, convertir la información temporal en una variable mes. Pero también se podía hacer otra lectura: ¿y si agrupo esos meses por estaciones? Entonces necesitaba construir, además, la variable estación. Como puedes ver, son dos variables muy similares, pero no son lo mismo. En este caso particular tomé la decisión de conservar las dos ya que cada una me permitía hacer una pregunta diferente.
La información estaba en los datos. Pero las variables que necesitaba para analizarla tuve que construirlas.
De una fecha a una pregunta
Esto puede parecer una transformación muy sencilla, y lo es. Pero precisamente por eso es un buen ejemplo de algo que ocurre constantemente en análisis de datos. Los datos originales contienen información. Nosotros decidimos qué parte de esa información necesitamos hacer visible para responder nuestra pregunta. Por ejemplo, en el tratado de los datos de asistencia. En la fuente, la información que necesitaba para comparar festivales estaba repartida en distintos campos de forma irregular. Para disponer de un indicador único tuve que combinarlos y construir una variable de asistencia total.
Lo mismo ocurrió con otras variables: normalicé la titularidad de los festivales, trabajé las categorías de ámbito artístico y preparé indicadores que después necesitaría para comparar grupos. Y en alguna ocasión incluso tuve que salir fuera del data set: construí el tipo de entrada (gratis, de pago mixto) a partir de búsquedas online. Parecen operaciones sencillas, y lo son. Pero sin esas decisiones no habría tenido medidas únicas con las que comparar los festivales.
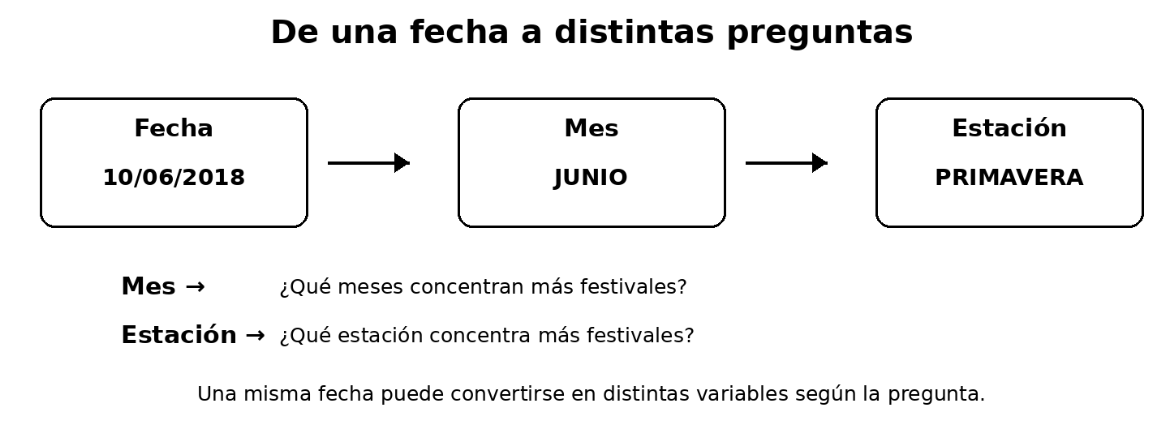
Una misma fecha puede convertirse en distintas variables según la pregunta.
Pero aquí hay una trampa
Que podamos construir una variable no significa que debamos hacerlo. Una variable derivada debería tener un propósito. La pregunta no debería ser: “¿Qué más columnas puedo crear?” sino:
“¿Qué necesito medir para responder a mi pregunta?”
Esta diferencia es fundamental. Y aquí vuelve a aparecer la triple dimensión del análisis. Técnicamente, necesito saber cómo transformar los datos. Analíticamente, necesito saber qué variable me ayudará a responder la pregunta. Epistemológicamente, necesito preguntarme qué estoy diciendo que representa esa variable. Por ejemplo, una estación no es una propiedad natural que estuviera escondida dentro de la fecha. Es una forma de agrupar el tiempo que resulta útil para determinadas preguntas. Esto mismo puede trasladarse a otros ámbitos.
Si trabajas con un museo quizá necesites convertir fechas de apertura y cierre en duración de una exposición. Si estudias actividades educativas quizá quieras construir una variable que agrupe las actividades por formato. Si analizas programación, quizá necesites derivar categorías de frecuencia, duración, público o temática. El principio es siempre parecido:
Tengo unos datos → tengo una pregunta → necesito una representación de los datos que me permita explorarla.
7. Ahora sí: empezar a mirar
Después de todo este trabajo llega una fase que probablemente sea la que más asociamos con un análisis de datos. Empiezo a explorar. Hago recuentos. Miro distribuciones. Calculo medias. Comparo categorías. Hago gráficos. Busco patrones. Y aquí aparecen algunos conceptos estadísticos básicos que conviene entender, porque son herramientas muy sencillas para empezar a hacernos preguntas. No hace falta convertir esto en una clase de estadística. Solo necesitamos saber qué pregunta responde cada herramienta.
Frecuencias: ¿qué aparece más?
Una frecuencia es, básicamente, cuántas veces aparece algo. Si tengo 67 festivales y 30 pertenecen a una determinada categoría, esa categoría tiene una frecuencia de 30. Podemos utilizar frecuencias para preguntas como:
- ¿qué ámbitos aparecen más?
- ¿cuántos festivales son públicos?
- ¿cuántos son privados?
- ¿cuántos son gratuitos?
- ¿qué meses concentran más festivales?
Es una de las primeras cosas que podemos hacer porque nos permite empezar a conocer la estructura del conjunto de datos. En otras palabras, antes de preguntarme cuánto, puedo preguntarme qué aparece más.
Media: ¿cuál es el promedio?
La media es probablemente la medida que más familiar nos resulta. Sumamos todos los valores y dividimos entre el número de observaciones.
- Si cinco festivales tienen:
- 1.000 · 2.000 · 3.000 · 4.000 · 50.000 asistentes
- la media es 12.000.
Pero hay algo interesante aquí. ¿Diríamos realmente que el festival “típico” de este pequeño conjunto tiene 12.000 asistentes? Probablemente no. Y eso nos lleva a la siguiente medida.
Mediana: ¿cuál está en el centro?
- Si ordenamos los valores y buscamos el que queda justo en medio:
- 1.000 · 2.000 · 3.000 · 4.000 · 50.000
- la mediana es 3.000.
En este ejemplo la diferencia entre media y mediana es enorme. ¿Por qué? Porque hay un valor muy alejado del resto. Es decir, si tengo algunos festivales con cientos de miles de asistentes y muchos otros con cifras mucho menores, la media puede quedar arrastrada hacia arriba. Mientras que la mediana me ayuda a localizar mejor el centro de ese conjunto. Y aquí aparece una de las razones por las que no conviene quedarse con una única medida para describir los datos. La media nos cuenta una cosa. La mediana, otra.
Moda: ¿qué aparece con mayor frecuencia?
La categoría que aparece con mayor frecuencia es la moda.
- Si tenemos:
- música · música · cine · música · literatura
- la moda es música, porque es la categoría que aparece más veces.
La moda resulta especialmente útil cuando trabajamos con variables categóricas. Y en este análisis tendrá una aplicación que recuperaremos más adelante: me permitirá construir el festival modal de Barcelona, una combinación hipotética de las características que aparecen con mayor frecuencia en el conjunto de datos. Pero antes de llegar ahí hay otra cosa que necesitamos mirar.
8. No basta con saber el promedio: hay que mirar la distribución
Una media puede ser útil. Una mediana también. Pero ninguna de las dos nos cuenta por sí sola cómo se distribuyen los datos. Podemos tener dos conjuntos con exactamente la misma media y, sin embargo, distribuciones completamente diferentes. Por eso, cuando hago un EDA, quiero mirar los datos en conjunto.
- ¿Cuántos valores se concentran alrededor de determinadas cifras?
- ¿Hay grupos claramente diferenciados?
- ¿Hay valores muy alejados?
- ¿La distribución es simétrica o está muy desplazada hacia un lado?
- ¿Dónde se encuentra la mayor parte de las observaciones?
Por eso, después de mirar medidas centrales (media, mediana y moda), tocaba mirar cómo se distribuían realmente las asistencias. Y aquí aparece otro concepto importante: los outliers.
¿Qué es un outlier?
Un outlier es un valor que se encuentra muy alejado del comportamiento habitual del resto de los datos. Pero cuidado: outlier no significa automáticamente error.
Si encuentro un festival con una cifra de asistencia extraordinariamente alta, puedo tener dos situaciones muy diferentes. Puede ser un error en los datos, o puede ser un festival que realmente tenga una escala extraordinaria. La forma de saberlo no es borrarlo porque “molesta” a la media. Es investigarlo. Y esto es exactamente lo que hace interesante la exploración. Un valor extraño puede ser un problema de calidad del dato. Pero también puede ser una pista.
En este caso, los valores extremos de asistencia empezaron a abrir una nueva pregunta: ¿Qué pasa si en lugar de considerar esos valores simplemente como excepciones los estudiamos como un fenómeno? Al mirar la distribución de asistencia a los festivales aparecieron valores muy alejados del resto. La primera reacción podría ser pensar que eran errores. Pero antes de eliminarlos quise saber qué representaban.
Y ahí apareció una pregunta nueva: ¿estábamos viendo simplemente valores extremos o había realmente un grupo de festivales de una escala diferente? Ese fue el punto de partida para estudiar los macrofestivales.
9. ¿Dónde empieza un macrofestival?
Aquí aparece una situación muy habitual cuando trabajamos con datos. Quiero estudiar una categoría que no existe en los datos originales. “Macrofestival” no era una variable de la base. Tenía que construirla. Pero entonces aparece la pregunta: ¿Cuántos asistentes hacen falta para que un festival sea “macro”? Podría haber elegido una cifra arbitraria.
- 10.000.
- 50.000.
- 100.000.
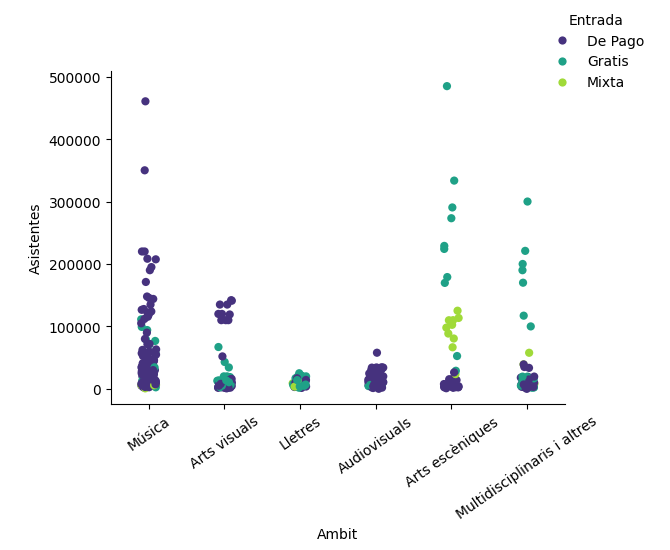
Pero ¿por qué esa y no otra? En lugar de eso, decidí mirar la distribución de asistentes y utilizar un cuantil.
¿Qué es un cuantil?
Imagina que ordenamos todos nuestros valores de menor a mayor. Un cuantil nos permite establecer puntos de corte en esa distribución. El percentil 50, por ejemplo, deja aproximadamente la mitad de los valores por debajo y la otra mitad por encima. Es la mediana. El percentil 25 deja aproximadamente un 25 % de los valores por debajo. El 75, un 75 %. Y podemos elegir otros puntos.
Al explorar la distribución de asistencia, vi que la mayor parte de los festivales se concentraba en cifras relativamente bajas y que, a partir de cierto punto, la distribución se hacía mucho menos densa. Ese cambio se situaba aproximadamente alrededor del percentil 85. El P85 se situaba en 57.800 asistentes. A partir de ahí definí como macrofestivales los festivales que superaban ese umbral.
- Esto me permite decir:
- Para este análisis, considero macrofestival a un festival que supera los 57.800 asistentes.
Pero hay una precisión importante. No estoy diciendo que 57.800 sea la frontera universal entre festival y macrofestival. Estoy construyendo una categoría útil para estudiar la parte superior de esta distribución concreta. Eso es muy diferente. Si hubiera elegido otro percentil, el corte habría cambiado y también el conjunto de festivales considerados macro.
Las categorías también las construimos
A partir de la distribución establecí cuatro categorías de tamaño:
| Categoría | Asistencia |
|---|---|
| Pequeño | ≤ 6.400 |
| Mediano | ≤ 12.700 |
| Grande | ≤ 57.800 |
| Macro | > 57.800 |
Los números no aparecieron mágicamente. Son el resultado de una decisión metodológica. Y aquí vuelven a cruzarse nuestras tres capas:
- Técnica: calculo la distribución y los cuantiles.
- Analítica: elijo un punto de corte que me permita estudiar la parte superior.
- Epistemológica: decido que esa categoría es una representación útil del fenómeno que quiero investigar.
Esta es una idea que me parece muy trasladable a otros ámbitos. Cuando analices museos quizá quieras definir qué es un museo “grande”. Cuando trabajes con exposiciones, qué significa que una exposición tenga una duración “larga”. Cuando estudies actividades, qué significa que tengan una participación “alta”. Los datos pueden ayudarte a construir criterios. Pero el criterio sigue siendo una decisión analítica que tienes que poder explicar.
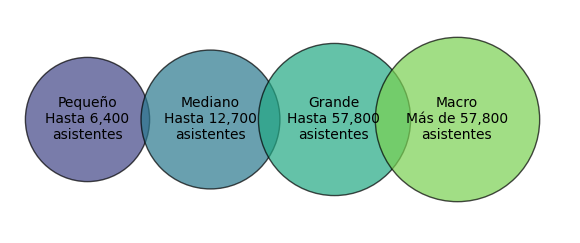
Categorías de tamaño utilizadas en el análisis según el número de asistentes. El umbral de macrofestival se establece en el percentil 85, por encima de 57.800 asistentes.
10. Antes de comparar, tengo que decidir qué estoy comparando
Otra intuición que quería poner a prueba era:
Los festivales gratuitos convocan más público.
La pregunta parece sencilla. Pero antes de calcular nada tuve que decidir algo bastante más básico: ¿Qué estoy comparando? Los datos contienen ediciones. Pero mi pregunta se refiere a festivales. Y eso no es exactamente lo mismo. Si un festival aparece durante diez años y otro solo durante tres, no quiero que el primero tenga automáticamente diez veces más peso simplemente porque tuvo más ediciones. Para esta comparación decidí utilizar el festival como unidad de análisis.
Calculé primero la asistencia media de cada festival a lo largo del período y después comparé los festivales gratuitos con los de pago. Con esta decisión gané una comparación más equilibrada entre festivales, pero dejé de ver la variación que puede existir entre sus distintas ediciones. Y aquí aparece otra lección que se puede trasladar prácticamente a cualquier análisis:
Antes de calcular una media, una frecuencia o una proporción, pregúntate qué representa una observación.
- ¿Una persona?
- ¿Una edición?
- ¿Una organización?
- ¿Un evento?
- ¿Un año?
La elección de la unidad de análisis puede cambiar completamente el resultado.
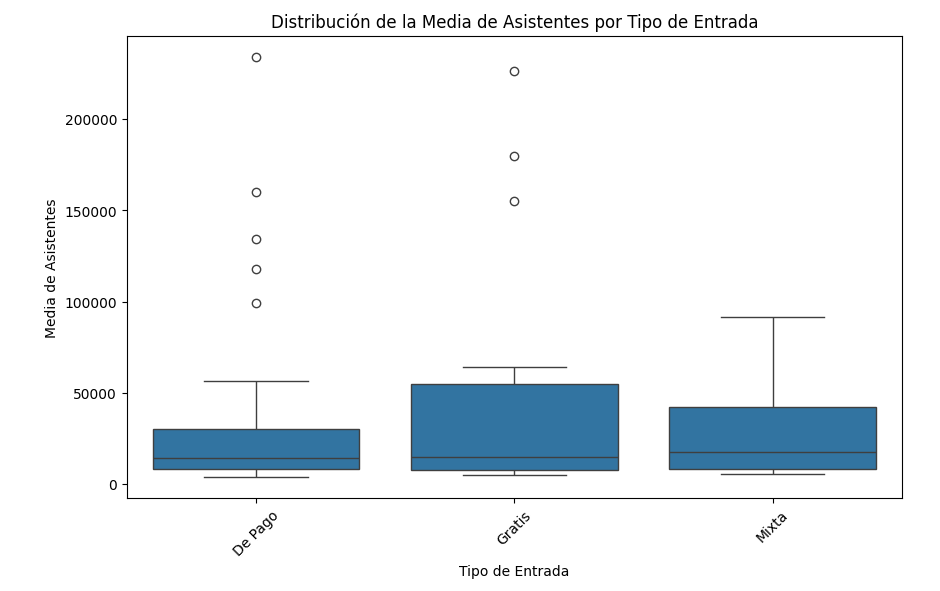
Distribución de la asistencia media de los festivales según el tipo de entrada.
¿Y qué ocurrió con la hipótesis?
La media de asistentes resultó ser aproximadamente similar en los dos grupos: alrededor de 12.000 asistentes. Además, los valores extremos aparecen tanto entre los festivales gratuitos como entre los de pago. Por tanto, la intuición de que “gratis significa más público” no se confirmó. Y me parece importante no intentar salvar la hipótesis a toda costa. No pasa nada. De hecho, este es uno de los resultados más interesantes del análisis. La hipótesis inicial era razonable. Los datos no la confirmaron en esos términos. Ahora sabemos algo que antes no sabíamos.
11. Una variable aislada rara vez cuenta toda la historia
Hasta ahora hemos mirado bastantes variables por separado. Pero llega un momento en que queremos cruzarlas. Por ejemplo: ¿Quién programa qué?
Si miro únicamente la titularidad, puedo saber qué proporción de festivales corresponde al sector público y cuál al privado. Pero todavía no sé si ambos sectores están presentes en los mismos ámbitos culturales. Cuando cruzo titularidad y ámbito, aparece una estructura más interesante. El sector privado domina en número, pero concentra especialmente música y audiovisuales, mientras que el sector público tiene una presencia relativa mayor en artes escénicas y letras. El cruce de variables nos permite ver algo que no aparecía mirando cada una por separado.
Y esto es otra característica fundamental de un EDA: una respuesta suele generar la siguiente pregunta.
Miro una distribución. Descubro algo. Cruzo otra variable. Descubro otra cosa. Y entonces vuelvo a mirar el dataset desde otro ángulo.
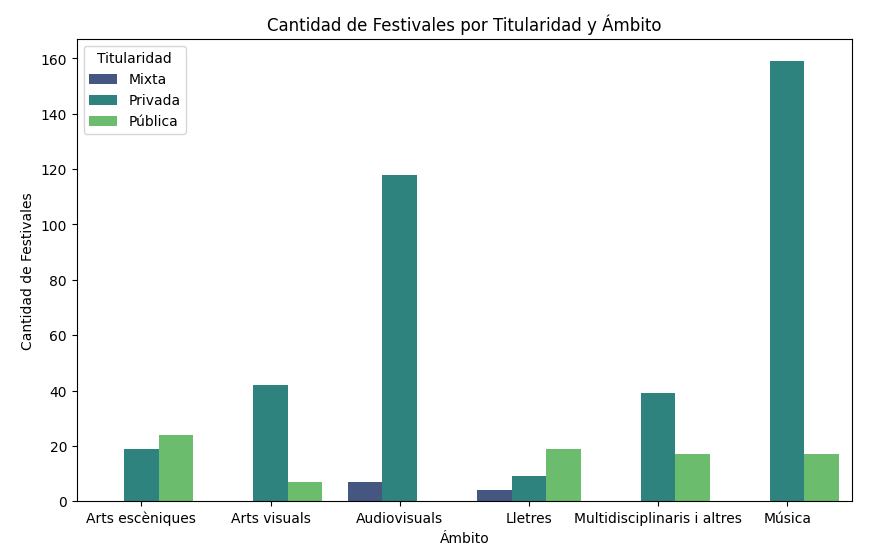
Distribución de los festivales según titularidad y ámbito cultural.
12. El tiempo también depende de cómo decidamos mirarlo
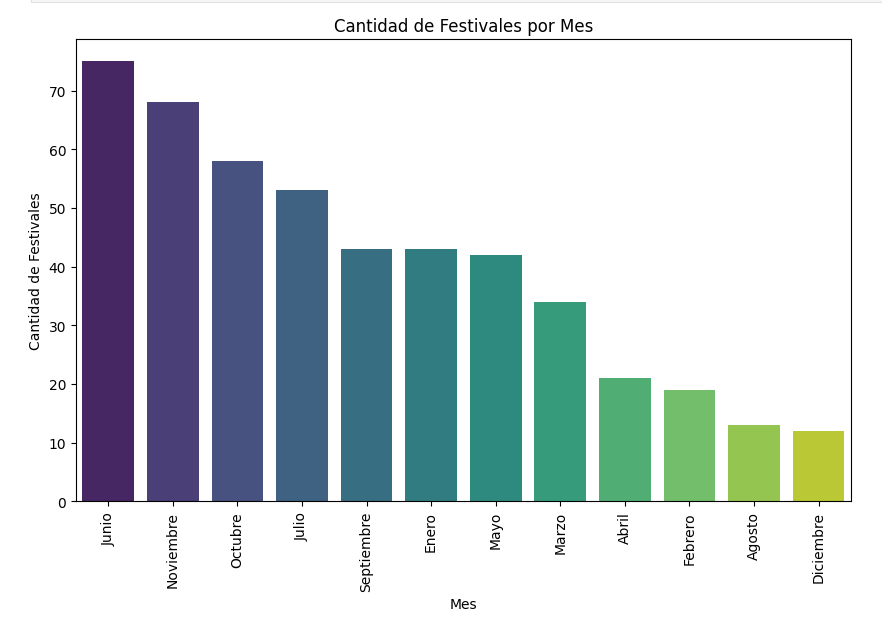
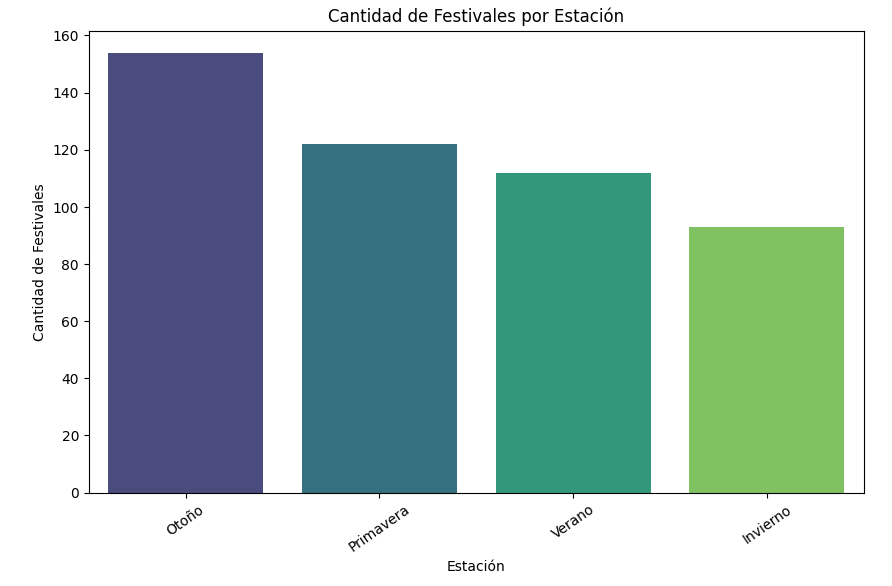
Algo parecido ocurrió con la temporalidad, como ya adelanté en otro capítulo de este artículo. Una de las intuiciones iniciales era que los festivales se concentrarían alrededor de los meses de calor. Pero para responder a esta pregunta temporal podemos organizar los datos de diferentes maneras. Entre otras, podemos mirar mes a mes, o podemos agrupar los meses en estaciones. Y lo interesante es que las dos lecturas no producen exactamente la misma imagen. Como mes aislado, junio es el que concentra mayor número de festivales. Pero cuando agrupo los meses por estaciones, otoño es la estación con mayor concentración.
Y no hay una contradicción. Lo que pasa es que estoy mirando el mismo conjunto de datos con dos agrupaciones temporales diferentes. Y esto es otro pequeño recordatorio de algo que atraviesa todo el análisis:
La forma en que organizamos los datos también forma parte de lo que podemos ver.
Por eso es importante no asumir que existe una única visualización o una única agrupación “correcta” para cualquier pregunta.
13. Ver un patrón no significa saber por qué existe
Aquí llegamos a una distinción que considero fundamental: si un gráfico muestra un patrón, puedo describirlo, pero no necesariamente puedo explicar su causa.
Es decir, puedo decir: “Estos meses concentran más festivales.” Eso es una observación sobre los datos. Puedo preguntarme después: “¿Por qué?”, y formular una hipótesis. Pero para convertir una hipótesis en una explicación necesitaría comprobarla con información adicional.
Esta diferencia entre describir, interpretar y explicar es importante porque los gráficos son muy persuasivos (y ya vimos lo mucho que dependen de las decisiones que tome quien hace el análisis). Una línea que sube parece estar contándonos una historia. Una diferencia entre dos grupos parece sugerir una causa. Un punto muy alejado parece necesitar una explicación. Pero el análisis tiene que resistirse a la tentación de contar una historia más grande que la que los datos permiten sostener.
Y esto es especialmente importante cuando trabajamos con fenómenos culturales, donde normalmente intervienen muchas variables que un único dataset no puede recoger.
14. Volver a las cuatro intuiciones
Después de todo este recorrido, podemos valorar las hipótesis iniciales. Y el resultado es bastante más interesante que un simple “verdadero/falso”.
| Intuición | Resultado |
|---|---|
| H1 El sector público programa ámbitos desatendidos por el privado | Matizada |
Los datos muestran una distribución diferente por titularidad y ámbito, sí; aunque no permiten, por sí solos, explicar por qué se produce esa distribución.
| Intuición | Resultado |
|---|---|
| H2 Los festivales se concentran alrededor del calor y la playa | Matizada |
El análisis muestra algo más interesante: hay concentración temporal, pero la historia depende de la escala con la que agrupemos los datos.
| Intuición | Resultado |
|---|---|
| H3 Los festivales gratuitos atraen más público | No confirmada |
Este caso es interesante para ver que una intuición no se confirme es un resultado, no un fracaso del análisis.
| Intuición | Resultado |
|---|---|
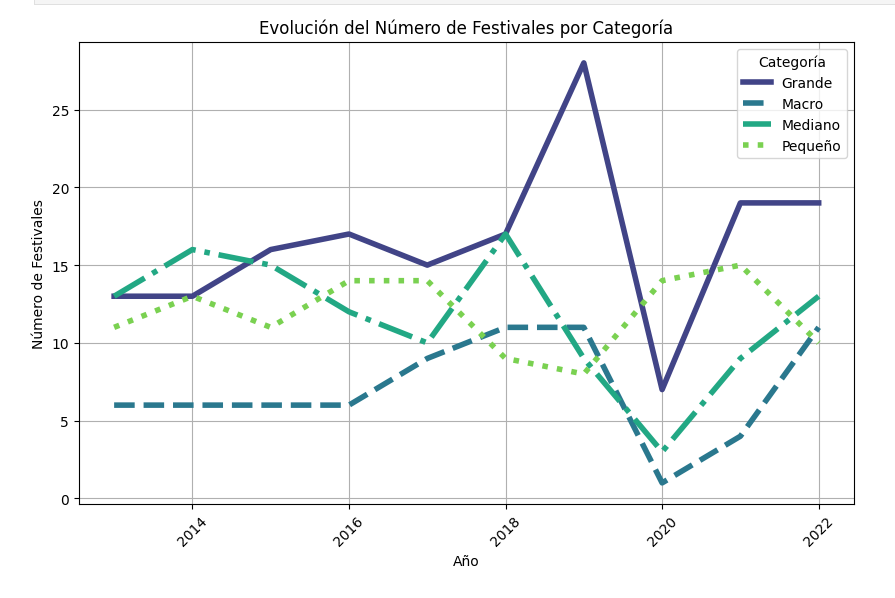
| H4 Han aumentado los macrofestivales | Confirmada con matices |
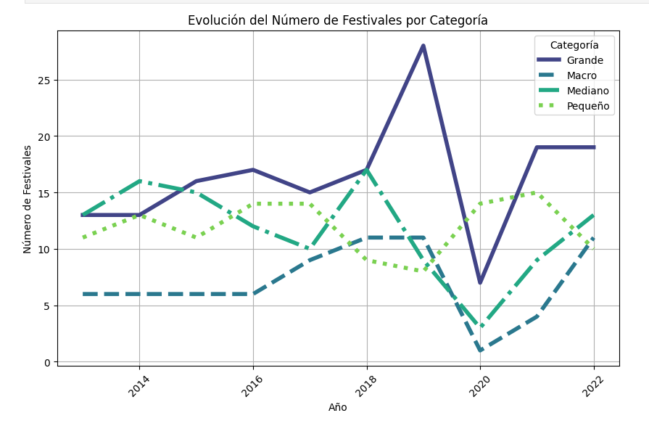
En el caso de los macrofestivales, por ejemplo, el análisis muestra un crecimiento durante la década, pero no una trayectoria lineal: el máximo se produce en 2018, la pandemia interrumpe la tendencia y después hay una recuperación sin superar ese máximo.
La gracia del análisis no está, por tanto, en haber acertado las cuatro intuiciones. Está en haber descubierto hasta dónde resistían cuando las ponía a prueba contra los datos.
15. El festival modal: cuando la moda se convierte en una historia
Volvamos ahora a aquella tercera medida de tendencia central que vimos al principio: la moda. Recordemos: la moda es el valor o categoría que aparece con mayor frecuencia.
Si aplicamos esta idea a distintas características de los festivales, podemos encontrar las categorías más frecuentes. Si tomo la categoría más frecuente en cada dimensión, puedo construir un «festival modal»: música, privado, de pago, programado en junio y perteneciente a la estación de otoño. Pero hay que entender bien qué significa. ¿Junio y otoño? No hay contradicción. Junio es el mes que aparece con mayor frecuencia y otoño es la estación que aparece con mayor frecuencia. Estoy agrupando los mismos datos de dos maneras distintas.
Los datos no han cambiado. Ha cambiado la pregunta que les estoy haciendo. Y me gusta porque permite convertir un concepto estadístico bastante abstracto en algo muy fácil de imaginar y en una herramienta para preguntar:
¿Cómo sería, aproximadamente, el caso más representativo si juntáramos las características que aparecen con mayor frecuencia?
16. Las tres capas de decisiones
Ahora, en modo retrospectivo, vemos más claramente que las decisiones tomadas a lo largo del proceso de análisis exploratorio fueron de tipos muy diferentes. Algunas tenían que ver con cómo trabajar los datos; otras, con qué comparar y qué universo construir; y otras, con qué significaba realmente cada variable dentro de la pregunta.
Es decir, como decíamos hacia el inicio del artículo, hay decisiones de diferentes tipos.
🔧 Técnicas
- ¿Cómo limpio?
- ¿Cómo transformo?
- ¿Cómo calculo?
- ¿Cómo agrupo?
- ¿Cómo visualizo?
🔎 Analíticas
- ¿Qué universo estudio?
- ¿Qué unidad de análisis utilizo?
- ¿Qué variables necesito?
- ¿Qué grupos comparo?
- ¿Qué umbral tiene sentido?
🧠 Epistemológicas
- ¿Qué estoy diciendo que representa este dato?
- ¿Qué significa “festival”?
- ¿Qué significa “grande”?
- ¿Qué significa “más público”?
- ¿Qué estoy dejando fuera?
- ¿Hasta dónde puedo generalizar?
Una decisión puede atravesar las tres capas al mismo tiempo. Los 57.800 asistentes son un buen ejemplo. Técnicamente, calculo un cuantil. Analíticamente, decido utilizarlo como punto de corte. Epistemológicamente, estoy construyendo una forma de representar qué entiendo por “macrofestival” dentro de este análisis. Esto es importante porque ayuda a entender algo que a veces queda oculto detrás del código:
El análisis no está determinado únicamente por los datos o las herramientas que utilizamos. También está determinado por las decisiones que tomamos.
17. Te toca
Quizá mientras lees esto estés pensando que todo esto está muy bien para los festivales, pero que tu ámbito es otro. Precisamente ahí está la gracia. Los festivales son solo mi ejemplo. Pero el mismo proceso podría servir para investigar preguntas sobre:
- exposiciones
- museos
- patrimonio
- actividades educativas
- bibliotecas
- proyectos comunitarios
- programación cultural
- públicos
- financiación
- participación
- comunicación cultural
- etc.
Si trabajas en el ámbito cultural, seguramente seas una persona curiosa y probablemente ya tienes alguna pregunta que podrías convertir en un pequeño EDA. Empieza por ahí.
a. Formula una pregunta
No hace falta que sea perfecta.
b. Busca qué datos existen
Mira los portales de datos abiertos y las fuentes oficiales relacionadas con tu ámbito.
c. Conoce los datos
Antes de analizarlos, averigua qué contiene realmente el dataset.
d. Límpialos
Y ten paciencia. Probablemente te lleve más tiempo del que imaginabas.
e. Construye las variables que necesites
Pregúntate qué necesitas medir para responder a tu pregunta.
f. Explora
- Cuenta.
- Compara.
- Visualiza.
- Mira distribuciones.
- Calcula medias, medianas y modas.
- Busca valores extraños.
g. Hazte nuevas preguntas
Si algo no encaja, no lo escondas. Investígalo.
h. Revisa tus intuiciones
- Puede que los datos te den la razón.
- Puede que no.
- Ambas cosas son interesantes.
Y, sobre todo:
No intentes llegar demasiado rápido a una conclusión.
Una buena EDA tiene algo de investigación detectivesca. Vas siguiendo pistas. Algunas no llevan a ninguna parte. Otras te hacen descubrir algo que no estabas buscando.
18. ¿Se puede hacer un EDA sin saber programar?
Creo que esto merece decirse porque durante mucho tiempo hemos tendido a pensar que para trabajar con datos primero hay que convertirse en programador. Hoy tenemos muchas más posibilidades.
En mi caso concreto, este proyecto lo hice dentro de un bootcamp, utilizando ejemplos de código que fui adaptando y ajustando a las necesidades del análisis, partiendo de nociones muy básicas de programación.
Y hay montones de herramientas de todo tipo que nos ayudan a aprender, adaptar, consultar, reutilizar y también generar código. Lo importante para un análisis como este no es demostrar que sé escribir cada línea de código desde cero. Lo importante es saber qué quiero averiguar, qué datos necesito, qué transformación tiene sentido, cómo comprobar que la he hecho bien y qué puedo concluir a partir del resultado.
La herramienta puede cambiar. El razonamiento sigue siendo necesario. Y esto me parece especialmente interesante para quienes trabajamos en ámbitos no tradicionalmente “tecnológicos”. No necesitas venir de la informática para empezar a hacer preguntas con datos. Puedes venir de la cultura, de la educación, de las ciencias sociales, de la gestión, del patrimonio, y empezar a experimentar.
19. Lo que finalmente me contaron los festivales
Después de todo este recorrido, podemos volver por un momento a las hipótesis del caso que lo originó. En estos diez años de datos, junio aparece como el mes con mayor concentración de festivales, mientras que otoño es la estación con mayor concentración. El sector privado domina en número, aunque público y privado presentan especializaciones diferentes según el ámbito cultural. La gratuidad no implica necesariamente una mayor asistencia. Y los macrofestivales aumentan durante la década, aunque con una evolución interrumpida y no lineal.
También puedo construir ese festival modal que resume las categorías más frecuentes: música, privado, de pago, junio y otoño.
Pero ahora estos resultados se leen de otra manera. Ya no son simplemente unas cifras que aparecen al final de un análisis. Sabemos de dónde vienen. Sabemos qué universo utilicé, cómo construí las variables, qué decisiones tomé y también qué no puedo concluir a partir de ellas.
20. Y aquí es donde el análisis vuelve a empezar
Una de las cosas que más me gustan de este tipo de trabajo es que una respuesta rara vez es realmente el final. Ya ves que en este EDA de ejemplo, algunas respuestas no cerraron preguntas: las abrieron.
Por ejemplo:
- Los macrofestivales: ¿qué factores explican esa escala?
- La distribución por titularidad y ámbito: ¿qué ocurre fuera del universo analizado?
- La menor presencia de festivales en verano: ¿tiene que ver con el turismo, las fiestas mayores u otros factores?
Empiezas preguntando algo. Encuentras una respuesta. Y esa respuesta te permite formular una pregunta mejor. Durante este análisis aparecieron, entre otras, preguntas sobre aquello que quedaba fuera del universo definido, sobre las categorías que había construido y sobre qué otras variables o fuentes podrían cruzarse con estos datos. No tengo que responderlas todas. De hecho, probablemente sería un error intentar hacerlo. Porque una EDA no tiene por qué terminar con todas las respuestas. Puede terminar con mejores preguntas.
Y quizá esta sea una de las mejores razones para animarse a hacer una.
Si tienes una pregunta, ¡prueba!
- No necesitas esperar a tener un gran proyecto.
- Busca una pregunta que te interese.
- Mira si existen datos abiertos que puedan ayudarte.
- Descarga un dataset.
- Ábrelo.
- Míralo.
- Ensúciate un poco las manos con él.
- Cuenta cosas.
- Encuentra algo raro.
- Pregúntate por qué.
- Construye una variable.
- Haz un gráfico.
- Descubre que tu primera intuición no era correcta.
- Vuelve atrás.
- Prueba otra cosa.
- No tengas miedo de que el análisis te lleve por un camino diferente al que imaginabas.
- Eso también es analizar.
Yo empecé queriendo saber algunas cosas sobre los festivales de Barcelona. Terminé aprendiendo mucho más sobre cómo hacer preguntas a unos datos, cómo conocerlos, cómo reconocer sus límites y cómo decidir qué puedo decir con ellos. Y esa experiencia se puede trasladar a muchísimos otros ámbitos. Los festivales fueron simplemente mi excusa para empezar.
La próxima pregunta puede ser la tuya.
Para seguir explorando
→ [Ver la presentación: Cómo (y cuánto) se festivalea en Barcelona]
→ Consultar el proyecto y los materiales en GitHub
→ Directorio de datos abiertos para investigar cultura (recurso en construcción)